本地量化系列教程 · 第一篇。系列目录见 README.md。
任何量化研究的第一步都不是"想策略",而是把数据搬到自己硬盘上。在线接口有限速、有失效风险、每次重跑实验都要重新请求;而本地 CSV 一旦落盘,回测就可以断点续跑、离线复现。这一篇讲清楚:如何用 akshare 拉取全市场 A 股名单与日线行情,如何批量下载并落盘,以及下载过程中那些教科书不会告诉你的坑。
配套代码来自工作区 A股个股历史行情数据获取.ipynb,全部数据已保存在 stock_data/ 目录(5400+ 只股票,2000-01 至 2025-07)。
1. 为什么"本地化"是量化的第一原则
在线数据源的三类问题,做过全市场回测的人都会遇到:
| 问题 | 典型场景 | 本地方案的应对 |
|---|---|---|
| 限速与配额 | tushare 每分钟请求数受限,5000 只股票拉一遍要几小时 | 一次下载,终身使用;增量更新只需补最新几天 |
| 接口变动 | akshare 爬取类接口随网站改版失效 | 数据已是 CSV,与接口解耦 |
| 不可复现 | 三个月前回测用的数据,今天重拉已经变了 | 每次回测读同一份文件,结果可复现 |
一条实际落地时推荐的数据流水线如下:
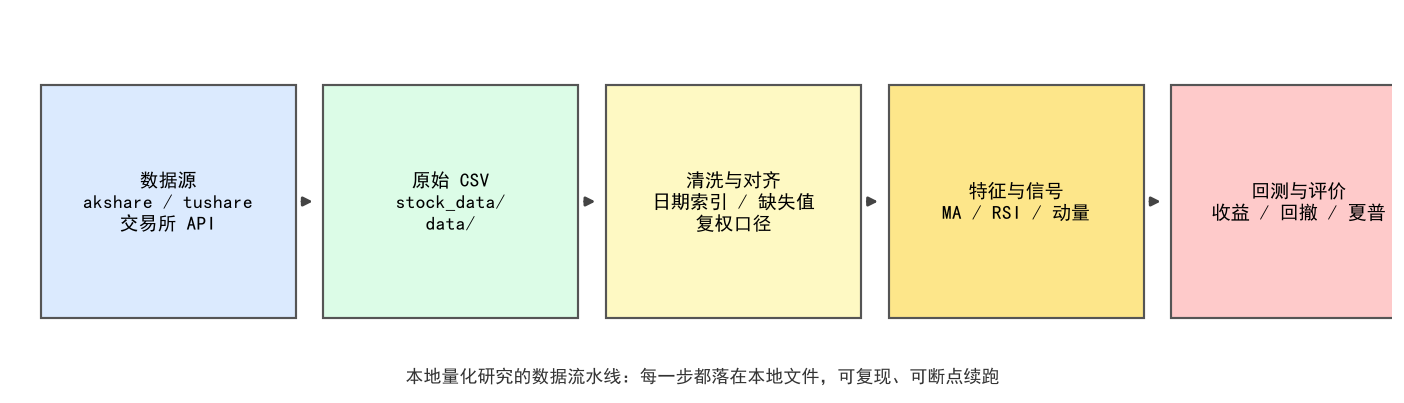
本文只覆盖前两步(获取与落盘),后续几篇覆盖特征、信号与回测。
2. 环境准备
pip install akshare pandas
import pandas as pd
import time
import akshare as ak
akshare 是免 token 的开源接口(底层爬取东方财富等公开页面),适合批量下载历史行情;tushare 数据质量更稳定但需要积分权限。本系列两套接口都会用到:批量落盘用 akshare,单票精细回测用 tushare。
3. 获取全市场股票名单
df = ak.stock_info_a_code_name()
print(df.head())
print(len(df))   # 约 5400+ 只
返回两列:code(如 000001)和 name(如 平安银行),覆盖沪深主板、创业板、科创板与北交所。
4. 批量下载日线行情
4.1 基本调用
stock_data = ak.stock_zh_a_hist(
    symbol='000063',           # 6 位股票代码,不带交易所后缀
    period='daily',
    start_date='20000101',
    end_date='20250720',       # 格式 YYYYMMDD
)
返回的 DataFrame 包含:日期、股票代码、开盘、收盘、最高、最低、成交量、成交额、振幅、涨跌幅、涨跌额、换手率。注意 股票代码 列会被识别成整数(63 而不是 000063),后续加载时要用 dtype 或字符串转换处理。
4.2 带限速的批量下载循环
start_date, end_date = '20000101', '20250720'

for index, row in df.iterrows():
    if index <= 147:          # 断点续跑:跳过已完成的
        continue
    time.sleep(2)             # 限速,对数据源保持礼貌
    stock_code, stock_name = row['code'], row['name']

    try:
        stock_data = ak.stock_zh_a_hist(
            symbol=stock_code, period='daily',
            start_date=start_date, end_date=end_date)
        file_name = f'{stock_name}_{stock_code}.csv'
        stock_data.to_csv(f'./stock_data/{file_name}', index=False)
        print(f'{index}-{stock_name}({stock_code})已保存')
    except Exception as e:
        print(f'获取 {index}-{stock_name}({stock_code})出错:{e}')
三个工程细节值得展开:
① 断点续跑。 5000 只股票 × 每只 2 秒限速 ≈ 3 小时,中途断网、关机都可能发生。if index <= 147: continue 就是最朴素的断点:记录上次跑到哪,下次从那继续。更稳健的做法是下载前先检查文件是否已存在。
② 异常不能让循环死掉。 try/except 把单只失败变成一条日志而不是程序崩溃——批量任务里"跳过失败、继续前进"永远是正确姿势,跑完再统一补抓失败名单。
③ sleep(2) 不是可有可无。 爬取类接口没有官方限速承诺,请求过快会被临时封 IP。2 秒一次是经验值:全程多花不了多少时间,但能把失败率压到很低。
4.3 坑:非法文件名字符
运行中会出现这样的报错:
获取 157-*ST宝实(000595)的数据时出现错误:
[Errno 22] Invalid argument: './stock_data/*ST宝实_000595.csv'
Windows 文件名不允许 * 等字符,而 ST 股票名称自带星号。解决方法很简单——落盘前清洗名称:
safe_name = stock_name.replace('*', '')
file_name = f'{stock_code}_{safe_name}.csv'   # 顺带把代码放前面,方便排序
5. 文件组织:把代码放在文件名前面
原始文件名是 名称_代码.csv,但按名称排序毫无意义,按代码排序才能和行情软件对照。重命名脚本:
import os

folder_path = './stock_data/'
for filename in [f for f in os.listdir(folder_path) if f.endswith('.csv')]:
    name, ext = os.path.splitext(filename)
    code = name.split('_')[-1]                       # 取末尾的代码
    new_filename = f'{code}_{name}{ext}'             # 代码放前面
    os.rename(os.path.join(folder_path, filename),
              os.path.join(folder_path, new_filename))
整理后的目录长这样(工作区 stock_data/ 的实际状态):
stock_data/
├── 000001_平安银行.csv
├── 000002_万  科A.csv
├── ...
├── 000063_中兴通讯.csv
├── ...
└── 689009_九号公司-WD.csv
提示:名称中的全角空格(如
万 科A)保留原样即可,代码列才是稳定的唯一键。永远用代码索引数据,不要用名称。
6. 验证与预览:拿到数据先画图
落盘 ≠ 拿到数据。先检查一份文件:
zte = pd.read_csv('./stock_data/000063_中兴通讯.csv')
zte['日期'] = pd.to_datetime(zte['日期'])
zte = zte.set_index('日期').sort_index()
print(zte.shape)        # (6033, 11)
print(zte.index.min(), zte.index.max())   # 2000-01-04 ~ 2025-07-18
zte['收盘'].plot(figsize=(10, 4), title='中兴通讯日线收盘价')
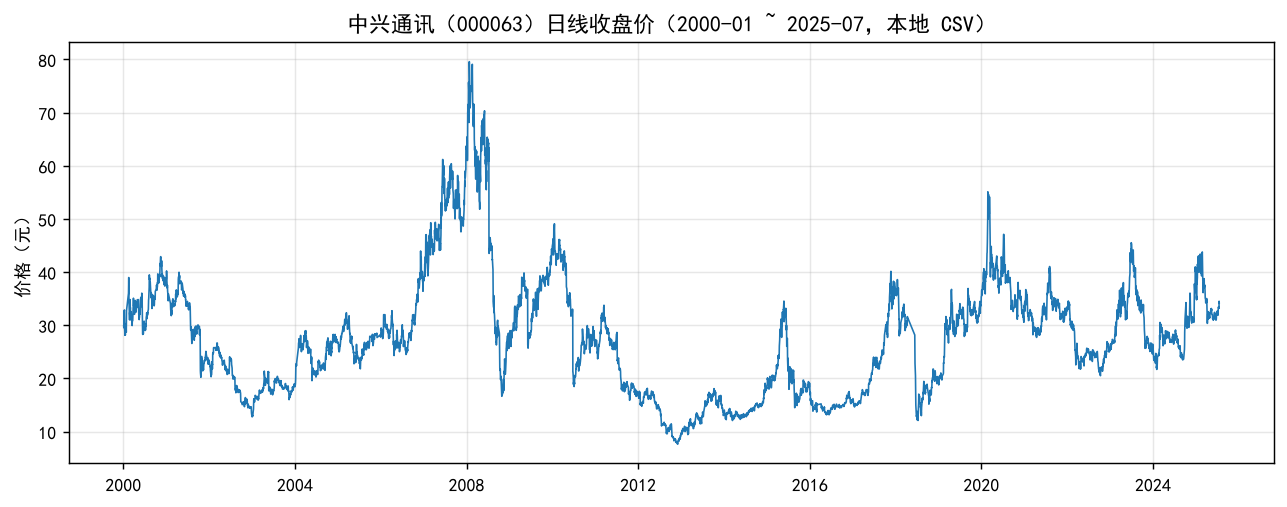
三个必查项:
- 时间范围对不对——输出显示 2000 年至今 6033 个交易日,与预期一致;
- 索引是否单调递增——
sort_index()保证后续shift、rolling不会在乱序数据上算出垃圾; - 有无异常值——涨跌幅列出现 ±44% 以上就要警惕(北交所 30%、ST 5% 涨跌停是正常的,其余要查复权)。
另外注意:stock_zh_a_hist 默认返回不复权价格,长期回测务必改用 adjust='qfq'(前复权),否则每次除权除息日都会出现一根假暴跌,趋势策略会在这些位置产生假信号。
7. 数字资产之外:加密货币数据的获取
工作区 data/ 目录还有一套 15 分钟 K 线数据(BTCUSDT 自 2017-08、DOGEUSDT 自 2019-07,来自交易所 API),格式为 datetime, open, high, low, close, volume,约 27.6 万行。获取这类数据的常见途径:
# 示例:用 ccxt 从币安拉取 K 线(交易所官方 API,无限速困扰,但单次仅返回 1000 根)
import ccxt
exchange = ccxt.binance()
ohlcv = exchange.fetch_ohlcv('BTC/USDT', timeframe='15m', since=..., limit=1000)
需要循环翻页拼接。本系列后续篇章的双均线回测就直接使用这套本地 BTCUSDT_15m_20170817_20250707.csv。
8. 小结与练习
本篇要点:
- 本地化优先:数据落盘一次,回测可复现、可断点、不依赖接口存活;
- 批量下载三板斧:断点续跑、异常跳过、礼貌限速;
- 文件名即元数据:
代码_名称.csv,永远以代码为唯一键; - 不复权数据不能用于长期回测,
adjust='qfq'是底线。
练习:
- (基础)把下载循环改成"先检查文件存在则跳过"的完整断点续跑版本;
- (进阶)给 5 只自选股票下载前复权数据,对比不复权版本,找出除权日造成的假跳空;
- (挑战)写一个增量更新脚本:只请求每只股票 CSV 末尾日期之后的行情并追加保存。
下一篇:02 · 向量化回测:双均线策略——用 pandas 十行核心代码完成第一个策略回测。