 第 8 篇:数据清洗与本地存储——CSV、SQLite 与 Parquet
上一篇我们用 akshare 拉到了行情数据,但你有没有想过一个问题:每次跑代码都重新去网上拉一遍,又慢又不稳,万一哪天接口抽风,你的策略研究就全停摆了。成熟的做法是:**数据拉一次,洗干净,存到本地,以后随取随用**。这一步听起来不像「量化」那么酷,却是所有靠谱量化工作的地基——数据错一步,后面全错。
16 阅读♡ 00 评论
数据获取环境搭建
第 8 篇:数据清洗与本地存储——CSV、SQLite 与 Parquet
上一篇我们用 akshare 拉到了行情数据,但你有没有想过一个问题:每次跑代码都重新去网上拉一遍,又慢又不稳,万一哪天接口抽风,你的策略研究就全停摆了。成熟的做法是:**数据拉一次,洗干净,存到本地,以后随取随用**。这一步听起来不像「量化」那么酷,却是所有靠谱量化工作的地基——数据错一步,后面全错。
 第 7 篇:金融数据获取——用 akshare 拉 A 股行情
上一篇画 K 线图时,我们代码里「偷偷」用过一次 akshare:拉了平安银行的日线数据。当时为了不喧宾夺主,只说了一句「失败就用本地模拟数据」。数据是量化的原料——没有数据,后面所有的指标计算、策略回测都是空中楼阁。所以本篇专门把 akshare 讲透:它是什么、怎么装、怎么拉数据、拉下来的字段都是什么意思,以及最重要的——怎么写才能让代码在接口变动或断网时也不至于直接崩溃。
 第 6 篇:数据可视化——matplotlib 与 K 线图
前五篇我们一直在跟数字打交道:NumPy 算数组,Pandas 读表格。你可能已经发现了,`df.head()` 打出来一大屏数字,看半天也看不出这支股票到底是在涨还是在跌。人眼对数字不敏感,但对图形极其敏感——一条曲线往上翘还是往下弯,一眼就看出来了。这就是为什么所有量化平台的第一屏都是图,而不是表格。
 第 5 篇:Pandas 进阶——时间序列与滚动计算
行情数据有一种别的数据没有的「方向感」:它沿着时间一去不回头。你问「这只股票最近 20 天平均多少钱」,其实是在时间轴上开一扇 20 天宽的窗;你问「从 4 月到 6 月涨了多少」,是在轴上切一段。上一篇我们用 DataFrame 装下了 OHLCV,但当时的日期还只是一列普通标签,没发挥出时间的威力。pandas 真正的看家本领恰恰在时间序列上:把日期变成真正的「时间索引」之后,按周按月聚合、滚动窗口计算、拿昨天比今天,全都变成一行代码。
 第 4 篇:Pandas 入门——Series 与 DataFrame
你多半用过 Excel:数据一行行排、字段一列列摆,想看某天的收盘价就顺着列名找,想算一列的平均就框住那一列拉个函数。这套「行 + 列名」的组织方式之所以流行,是因为它和人类整理信息的直觉天然合拍。量化里的数据——每天的开盘价、最高价、最低价、收盘价、成交量——恰恰就是一张典型的表格。上一篇我们认识了 NumPy 的 ndarray 和「向量化」思维:一整列数字同时开方、同时求和,一行代码搞定。但 ndarray 有个不方便的地方:它只认位置、不认名字。第 0 列是什么字段?第 100 行是哪一天?全得靠你自己记在心里。真实行情是「带名字」的:这一列叫收盘价、那一行是 2024 年 6 …
 第 3 篇:NumPy 核心:ndarray 与向量化思维
能用 np.array、np.zeros、np.arange、np.linspace、np.full 五种方式创建 ndarray,并说出彼此的适用场合;能读写 ndarray 的 dtype(元素类型)与 shape(形状),并解释「二维数组 = 行是股票、列是交易日」的约定
 第 2 篇:Python 基础速成:面向量化的语法精要
能用 list、dict、tuple、set 分别保存行情数据,并说清四者各自适合什么场合;能用切片取出「前 N 只」「每隔一只」「倒序」等子序列,并解释「切片是视图」的含义
 第 1 篇:为什么学 Python 量化与环境搭建
能用自己的话说清量化交易和手工交易的差别,以及它适合解决什么问题;能独立安装 uv,并用它为本合集创建一个独立的虚拟环境
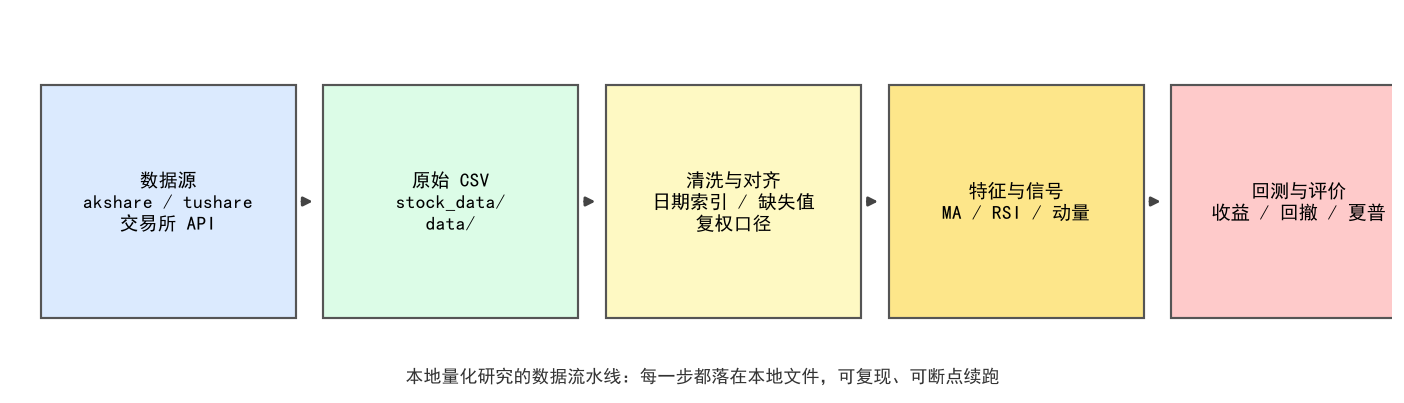 01 · 数据基石:批量获取与整理 A 股历史行情
用 akshare 把全市场 A 股日线拉成 5000+ 份本地 CSV(2000-01 至 2025-07):sleep(2) 限速、断点续跑、异常跳过,ST 股票名称自带星号会让 Windows 落盘报 [Errno 22],文件名统一改成 代码_名称.csv。拿到数据先查时间范围、索引是否单调、涨跌幅有没有异常值,并注意 stock_zh_a_hist 默认返回不复权价格,长期回测要用 adjust='qfq',否则每个除权日都是一根假暴跌。