本地量化系列教程 · 第六篇(完结篇)。配套笔记本:
量化指标回测神器quantstats.ipynb、pyfolio量化回测评价.ipynb、批量回测.ipynb;数据:data/BTCUSDT_15m_*.csv与stock_data/全部 5258 份本地 A 股 CSV。
前五篇的策略回测都有一个共同的幸存者偏差:我们只在一只股票上试了策略。一只股票上看起来赚钱的参数,放到全市场可能一半股票上亏钱;反过来,全市场的统计规律才是策略真正可依赖的证据。这一篇做两件事:一是用 quantstats/pyfolio 把单策略的绩效评价标准化(一键 tear sheet);二是把策略批量跑遍全市场,用分布而不是单点来下结论。
1. 单策略绩效评价:quantstats
1.1 为什么需要专业工具
前几篇我们手写了收益、夏普、回撤——入门够用,但严谨的绩效报告还需要 Sortino、Calmar、VaR、尾部比率、月度分布、滚动指标……每篇都手写一遍既低效又不标准。quantstats(以及更重型的 pyfolio)把这些做成了一行调用。
pip install quantstats
import quantstats as qs
import pandas as pd
import numpy as np

# 以 BTC 双均线策略(02 篇)的 15 分钟收益为例
date_index = pd.date_range(start='2020-01-01', periods=1000)
stock_returns = pd.Series((np.random.random(size=1000) - 0.5) / 10, index=date_index)

# 一键输出完整 HTML 报告(工作区的 performance.html 就是这么来的)
qs.reports.html(stock_returns, output='performance.html')
工作区中的 performance.html 即原笔记本生成的真实产物。核心 API 只有三层:
qs.stats.sharpe(returns)              # 单个指标计算(70+ 个指标可选)
qs.stats.rolling_sharpe(returns, rolling_period=20)   # 滚动指标
qs.plots.snapshot(returns)            # 绘图
qs.reports.html(returns, output=...)  # 完整报告
常用指标速查:
| 指标 | 函数 | 回答的问题 |
|---|---|---|
| 夏普比率 | sharpe |
每承担一份波动换来多少收益 |
| Sortino | sortino |
只惩罚下行波动的夏普 |
| 最大回撤 | max_drawdown |
最惨时亏掉多少 |
| Calmar | calmar |
年化收益/最大回撤 |
| VaR / CVaR | value_at_risk / cvar |
尾部风险有多大 |
| 月度收益表 | monthly_returns |
收益的时间分布是否稳定 |
| 盈亏比 | profit_factor |
总盈利/总亏损 |
1.2 手搓 tear sheet:看懂报告里的每一块
工具的价值在于快,但读懂报告是另一回事。我们自己把四个核心板块画出来(以 02 篇 BTC 双均线策略的真实收益为例):
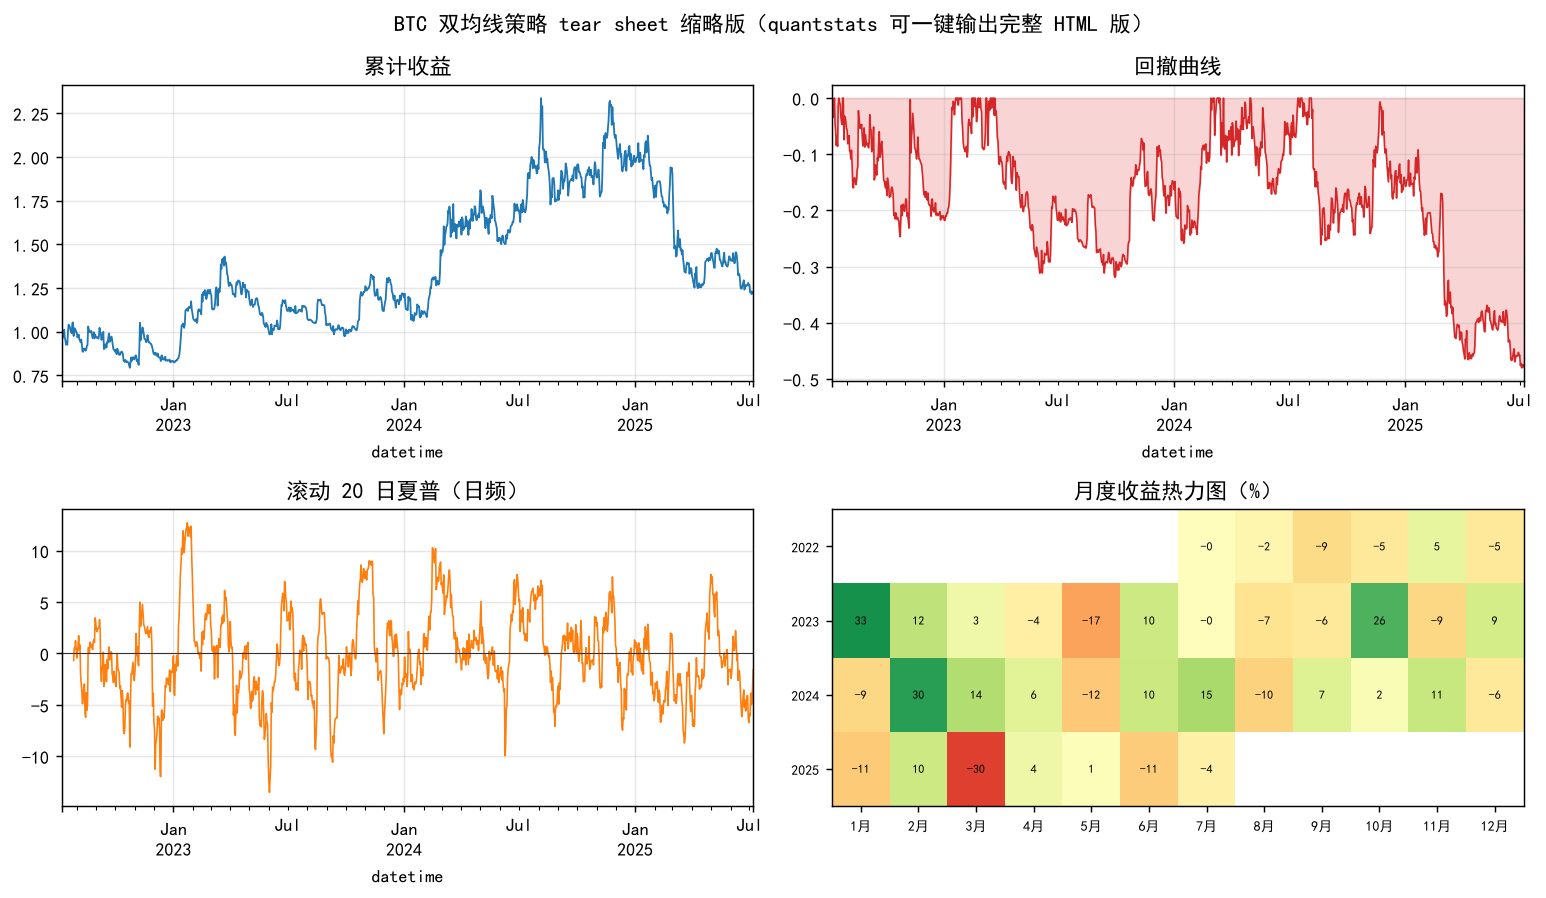
- 累计收益(左上):净值曲线的整体形状,一眼判断策略属于"慢慢涨"还是"一次豪赌";
- 回撤曲线(右上):从历史高点回落的比例,注意它和收益曲线是同一个信息的风险视角;
- 滚动 20 日夏普(左下):绩效不是常数。好策略的滚动夏普围绕一个稳定中枢波动;如果靠某两三个月撑起全部绩效,其余时间为负,那本质上是"押中了两次行情";
- 月度收益热力图(右下):收益在时间上是否集中。集中 = 尾部依赖 = 未来不可复制。
拆解口径注意:15 分钟对数收益聚合成日收益时,对数收益直接 sum,简单收益必须 comp(连乘)——混用是最常见的自欺错误之一。
pyfolio(本工作区用的是维护更活跃的
pyfolio-reloaded包)提供更完整的create_full_tear_sheet(returns, benchmark_rets=...),还能做归因、滑点分析,但它对数据格式(交易日历、基准对齐)要求更苛刻。建议入门用 quantstats,进阶再上 pyfolio:
python
import pyfolio_reloaded as pf
pf.create_returns_tear_sheet(returns, benchmark_rets=benchmark)
2. 批量回测:全市场才是策略的试金石
2.1 从"一只票的结果"到"5000 只票的分布"
单票回测回答"这个策略在这只票上历史表现如何";批量回测回答"这个策略的统计规律是否存在"。实现思路朴素:读入 stock_data/ 每一份 CSV → 统一列名 → 套同一个策略函数 → 收集每只票的指标 → 看分布。
import os, pandas as pd, numpy as np

def load_stock(file_path, tail=131):
    """读取单只股票,取最近 tail 个交易日"""
    t = pd.read_csv(file_path).tail(tail)
    return pd.DataFrame({'close': pd.to_numeric(t['收盘'], errors='coerce')})

def momentum_strategy(close):
    """04 篇的 5 日动量(对齐后滞后 5 天执行)"""
    ret = np.log(close / close.shift(1))
    pos = np.sign(ret.rolling(5).mean())
    return (pd.Series(pos, index=close.index).shift(5) * ret).dropna()

results = []
for fn in os.listdir('./stock_data'):
    if not fn.endswith('.csv'):
        continue
    try:
        data = load_stock(os.path.join('./stock_data', fn))
        strat = momentum_strategy(data['close'])
        if len(strat) < 60:
            continue
        results.append({
            'ticker': fn[:-4],
            'ret': float(strat.sum()),
            'sharpe': float(strat.mean() / strat.std() * np.sqrt(252)),
        })
    except Exception:
        continue        # 坏文件跳过,跑完再补抓

res = pd.DataFrame(results)
原笔记本跑完 5000 只的实际结果:整体胜率 0.50、平均对数收益 0.07——接近抛硬币。这就是批量回测的冷酷价值:单票上 +228% 的"最优窗口"(04 篇),放到全市场瞬间现出原形。
2.2 分布视角
我们用全部 5258 份本地 CSV 重跑(每只最近 131 个交易日,5 日动量、滞后执行、无成本):
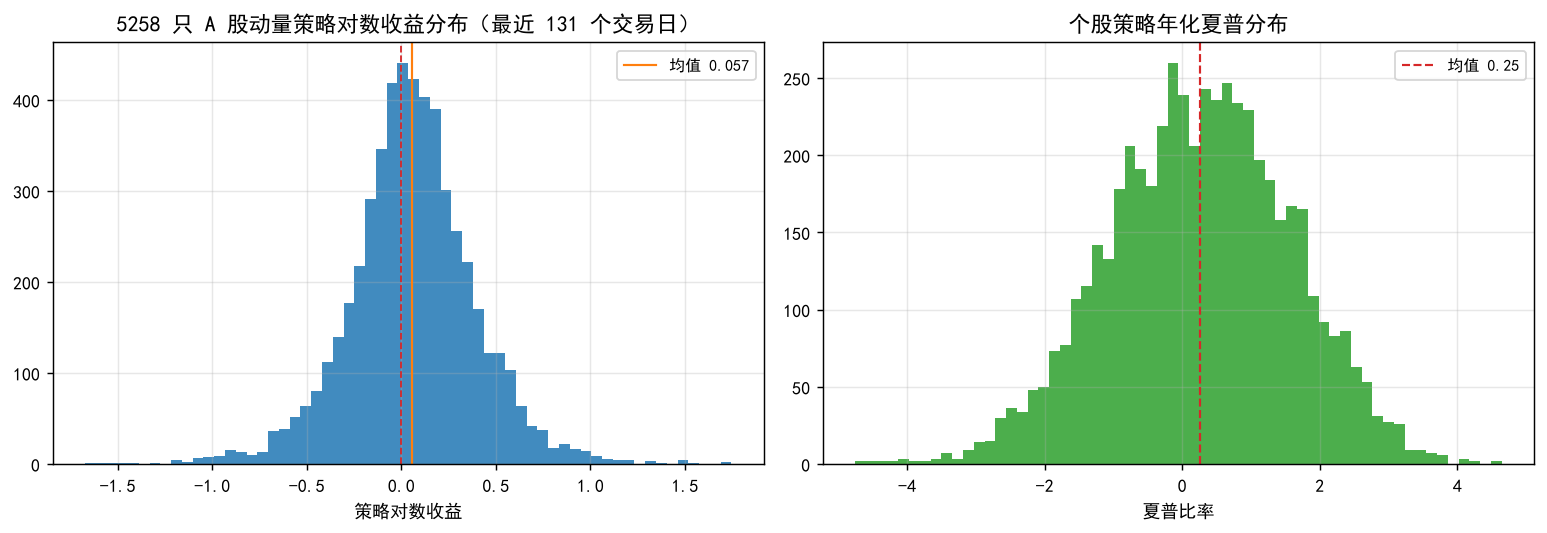
实际统计:
| 统计量 | 数值 |
|---|---|
| 样本数 | 5258 只 |
| 对数收益均值 | +0.057 |
| 中位数 | +0.055 |
| 收益为正的比例 | 57.7% |
| 夏普均值 | 0.25 |
怎么读:
- 均值 +0.057 但分布极宽:右尾有暴赚的,左尾有腰斩的。单票结果落在分布的哪一端,几乎是运气;
- 57.7% 为正:比抛硬币好一点,但一个"年化 ~11% 对数收益、夏普 0.25"的无成本策略,加上 0.1% 双边成本与频繁换手后大概率归零——平均意义上并不存在可实盘的优势;
- 分布的中枢才是策略的真实水平,右尾的明星只是样本噪声。 如果想让策略"值得实盘",目标是把分布整体右移(更好的信号),或把左尾剪短(风控),而不是去挑右尾的票。
2.3 批量回测的工程要点
- 统一数据清洗:列名标准化(中文 → 英文)、
pd.to_numeric(errors='coerce')容忍脏数据、停牌/新股样本按最短长度过滤; - 异常不中断:
try/except记录失败清单,跑完统一补(01 篇批量下载的同款纪律); - 防幸存者偏差:本工作区的数据是"现存 5000+ 只"的快照,退市股不在内——真实的全市场回测要包含已退市股票,否则收益分布会系统性偏高;
- 防前视偏差:策略函数对每只票独立、只用自身历史,
shift纪律与单票回测完全一致; - 结果落盘:
results_df.to_csv('batch_results.csv'),后续分析不要重新跑 40 分钟的批量任务。
3. 系列总结:一套完整的本地量化工作流
六篇走完,把整条链路串起来:
| 篇 | 环节 | 核心交付 |
|---|---|---|
| 01 | 数据获取与落盘 | stock_data/ 5258 份 A 股 CSV + data/ 加密货币分钟线 |
| 02 | 向量化回测(双均线) | 信号对齐 shift(1)、年化/夏普/回撤三件套、参数网格 |
| 03 | 均值回归 | 通道突破+回归离场,三态持仓,风格与趋势互为镜像 |
| 04 | 动量 | sign(rolling mean),参数敏感性与噪声的识别 |
| 05 | 事件驱动回测(RSI) | 现金+持仓状态机、成本、胜率与盈亏比的联合解读 |
| 06 | 绩效评价 + 批量回测 | quantstats tear sheet、全市场分布视角 |
贯穿全系列的五条纪律:
- 数据本地化:落盘一次,复现终身;增量更新与历史归档分开;
- 时间对齐:信号与收益之间永远隔着一个
shift,宁可多 shift 不可少 shift; - 成本先行:任何"无成本回测"的结论都要乘一个折扣系数,短周期策略折扣更深;
- 分布思维:单票结果是样本,全市场分布才是证据;参数最优点不可信,参数邻域平滑才可信;
- 两段式验证:向量化扫参数 → 事件驱动复核 → 模拟盘 → 实盘小资金,一级一级过。
4. 接下来去哪
- 回测框架升级:backtrader、vectorbt、vn.py——把本系列手写的引擎换成工业级实现,重点学习它们的撮合与订单管理;
- 数据扩展:分钟级 A 股、财务与基本面因子、订单簿数据;
- 因子化:把 03/04 篇的策略改写成因子(cross-sectional 排序),用 IC/分组回测检验(参见 worldquant 类平台的思路);
- 组合与风控:多策略加权、波动率目标、 Kelly 上限,以及最重要的——模拟盘跑满三个月再谈实盘。
上一篇:05 · 事件驱动回测 · 返回:README · 课程目录