这个项目解决什么问题
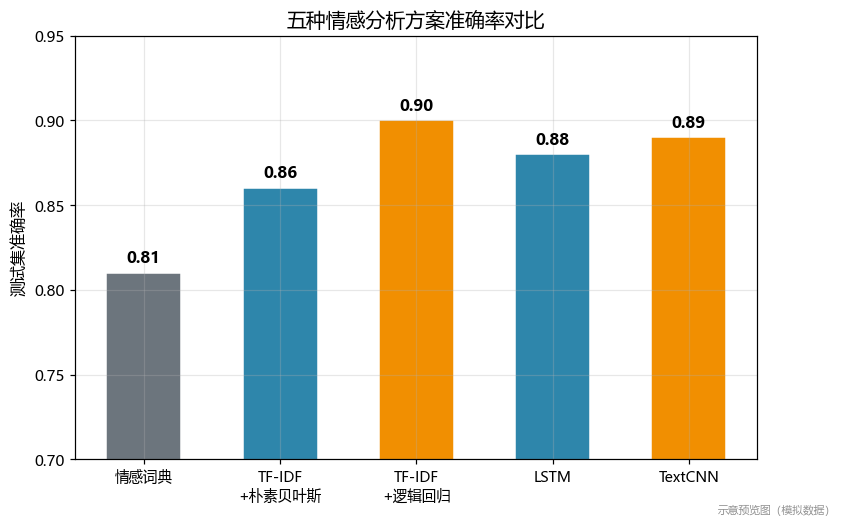
大多数 NLP 入门项目只教一条路:TF-IDF + 逻辑回归,跑个准确率就结束。本项目让五套方案在同一数据、同一评估口径下正面交锋:准确率差多少?训练成本差多少?可解释性差多少?看完对比表,你对"什么场景该用什么模型"会有自己的判断——这比多调一个模型值钱。
核心亮点
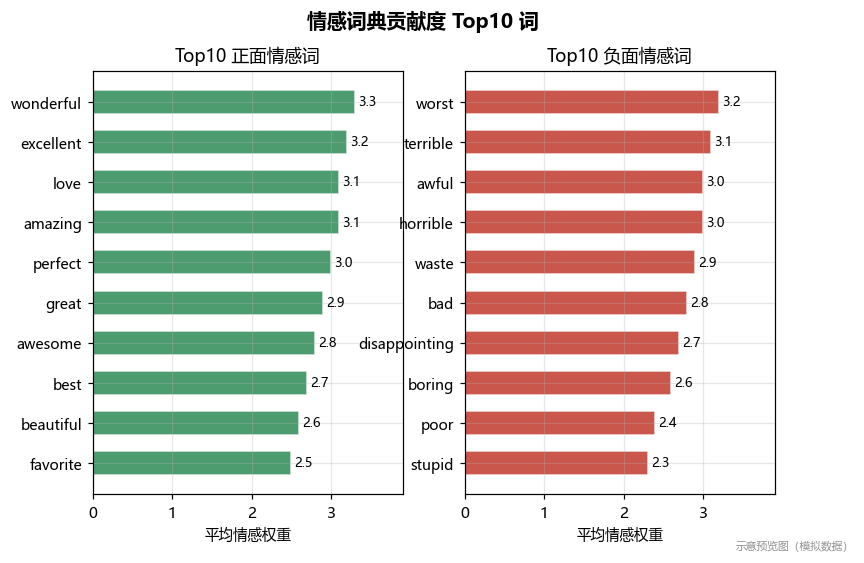
- 自建情感词典:不用现成的 VADER——从训练集统计每个词的极性分数(对数似然比),对评论直接打分。它准确率不是最高,但每个词的打分理由都能打印出来,是绝佳的可解释基线,也是这个项目里"自己动手"含量最高的模块之一。
- TF-IDF + 朴素贝叶斯 / 逻辑回归:词袋路线的经典双雄,全量 5 万条训练,几分钟出结果。
- Word2Vec 词向量方案:gensim 在语料上自训练词向量,平均池化后接逻辑回归——"语义"路线的第一次尝试。
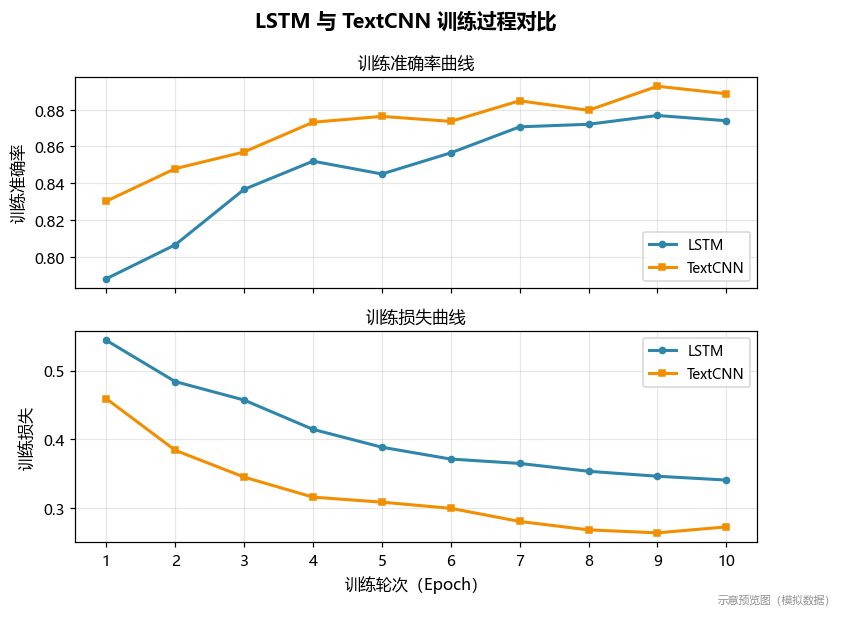
- LSTM 与 TextCNN 对照实验:两个深度模型用相同的数据子集、相同的序列化配置公平比武,训练曲线放在一张图里。TextCNN 为项目内自实现(多尺寸卷积核 + 池化),不是复制粘贴的示例代码。
- 词级贡献高亮解释:逻辑回归系数 × TF-IDF 值定位推动预测的关键词,生成绿/红高亮的 HTML——"为什么这条评论被判为正面",模型自己会解释。
- 实时预测接口:
predict_sentiment()对任意一句评论即时输出情感判断,课程汇报现场输入一句话就能演示。
效果预览
情感词典自动学出的正负面词 Top10——方向完全正确,这就是可解释性:
五套方案准确率总览,技术演进的成本与收益一目了然:
LSTM 与 TextCNN 的训练曲线对照:
预览图基于模拟数据演示实际运行效果,真实数据运行结果以你下载的数据集为准。
你将学到
- 文本预处理全流程:清洗、分词、停用词、(可选)词干化
- 两种文本表示(TF-IDF / 词向量)的本质差异与适用场景
- 传统 ML 与深度学习模型在文本分类上的真实差距
- 深度模型的可解释性实践:让"黑盒"开口说话
适合谁
NLP 方向入门进阶、或想要一个"技术栈全面 + 有对比深度"毕设的学习者。难度 ★★★☆,传统模型全量可跑,深度模型按机器性能调节子集大小。
情感词典的打分公式、TextCNN 的卷积结构怎么搭的——源码注释里都有,这里刻意没有展开,留给你自己探索。
交付内容:完整可运行源码、README.md(逐步运行方法与实现说明)、requirements.txt。
数据集:第三方数据受原始授权限制不随包分发,按 README.md 里的官方链接下载放入 data/ 即可跑通全流程。
许可:个人使用,可用于自己的学习、课程实验与研究报告,请勿转售或公开传播。