这个项目解决什么问题
直接用通用大模型备课的问题很具体:它不认识你这学期用的那版教材,也不知道你们学校的课标要求,写出来的教案"看着像、用不上"。而把资料整段塞进 prompt 又会撑爆上下文,还每次重新塞。
本项目做的是每个老师一份私有知识库:上传 PDF / Word / TXT / MD(≤20MB),系统解析、分块入库;生成教案、配套习题、教案点评时先做检索,把命中的知识块连同相关度一起交给模型;结果自动存入历史记录,可导出 Word 或 PPTX,也可以"修改后再导出"。
核心亮点
- 零依赖向量检索:TF-IDF + 字符 n-gram 哈希做相似度,不装向量库、不接 embedding 服务就能跑通 RAG;接口留好,换成真 embedding 只改一处(原理文档里写了怎么换)。检索结果带相关度数值,命中了什么、为什么命中,页面上直接能看。
- 账号与数据隔离:文档、会话、历史记录全部按用户隔离,越权访问在服务端拒绝。密码用标准库
pbkdf2_hmac加盐哈希,token 用secrets生成存库,零第三方认证依赖。 - 教案 / 习题 / 点评三种生成:点评按结构完整性、目标可测性、过程设计、评价与反馈、板书与资源五个维度打分;生成后可直接改再导出。
- PPTX 导出防溢出:文字长了不是压字号就是分页,
backend/exporters.py里对文本框做了溢出处理——这类细节通常要在真机上踩过一次才写得出。 - LLM 可插拔:默认 MockProvider(确定性输出,离线可跑可测),配环境变量即可切 OpenAI 兼容接口,不配也能把整条链路演示完。
- 第二轮深度测试修掉 11 个后端 bug:其中包括 RAG 哈希碰撞导致噪声污染教案——修复记录写在
项目原理.md的专门章节里。
效果预览
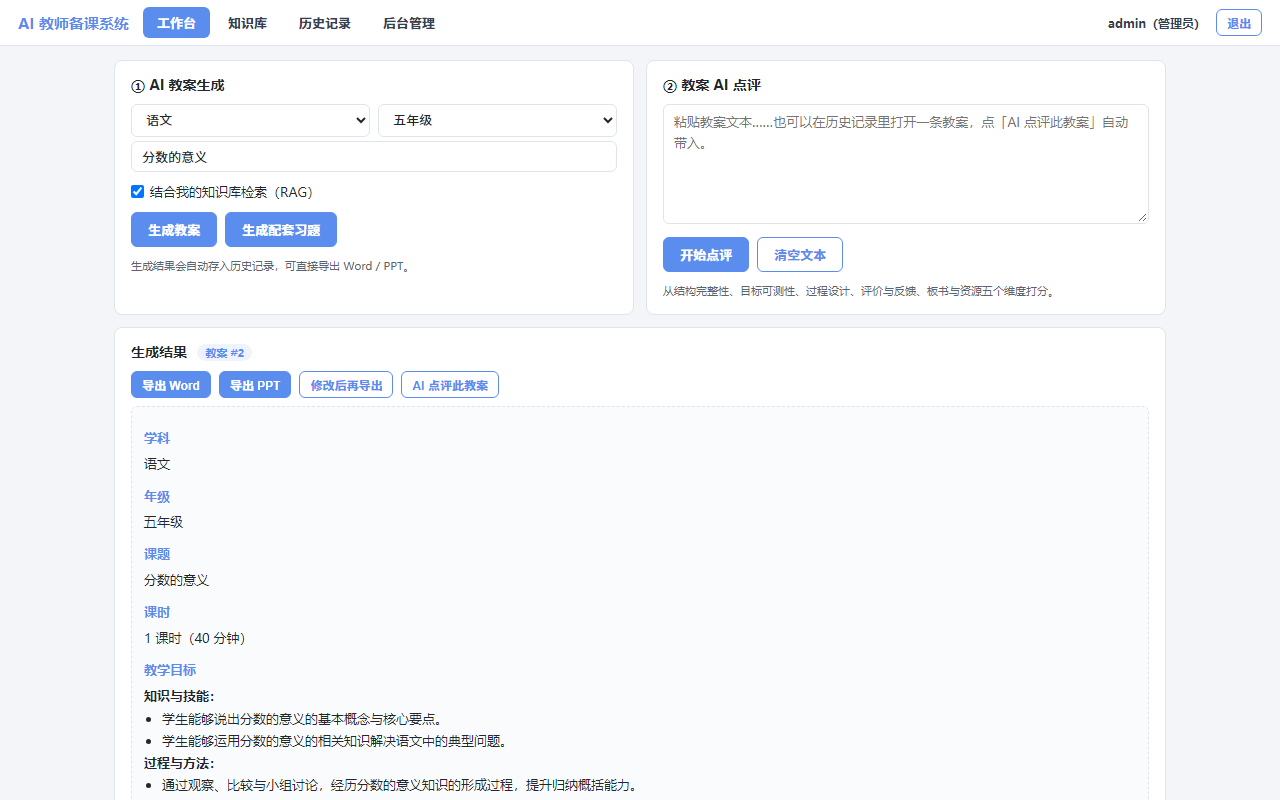
工作台填学科 / 年级 / 课题,点「生成教案」后的结果区:教案编号、导出 Word / PPT、修改后再导出、AI 点评此教案都在同一屏:
知识库页:上传一份《分数的意义》教材要点后做检索,两条命中各带相关度(0.1469 / 0.1252),下方是文档分块列表:
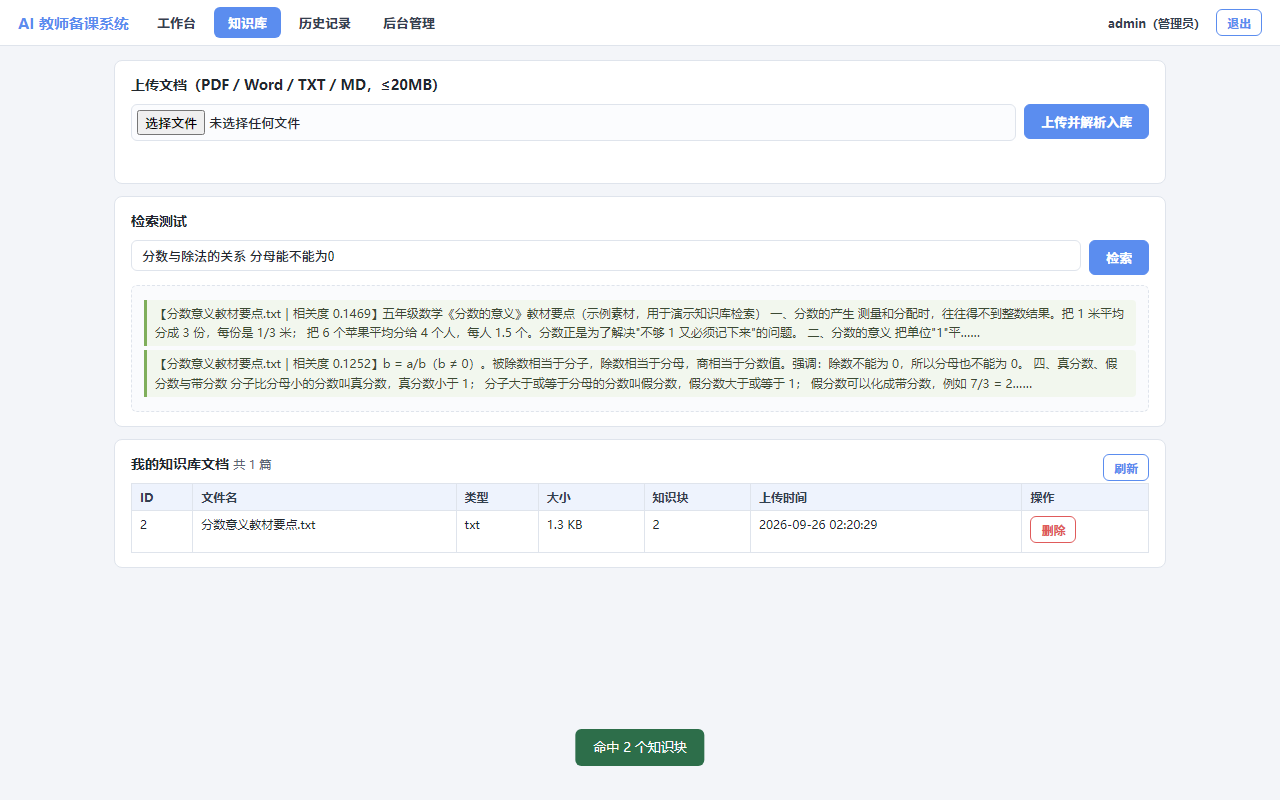
两张都是本机 8002 端口实际运行界面截图,非设计稿。
你将学到
- 怎么用 FastAPI 组织一个有登录、有权限、有后台的多用户系统
- RAG 的最小可用实现:分块、TF-IDF 检索、把命中段拼进 prompt、展示相关度
- 不装向量数据库也能做检索增强,以及什么时候确实该换真 embedding
- Word / PPTX 程序化导出与排版溢出处理
- 用 Mock Provider 把"AI 功能"变成可写断言的确定性组件
适合谁
想做一个"真的能用的 AI 应用"而不是 demo 的人——多用户、权限、检索、导出、后台这五件事齐全,才有交付价值。难度 ★★★☆,FastAPI 有基础读起来很顺;项目原理.md 里逐节写了架构、RAG 取舍、防溢出实现、测试方法与局限。
交付内容:完整可运行源码、README.md(逐步运行方法与实现说明)、requirements.txt。
许可:个人使用,可用于自己的学习、课程实验与研究报告,请勿转售或公开传播。