这个项目解决什么问题
情感陪伴类 Agent 最容易做错的地方不是模型不够大,而是没有阶段概念:认识第一天的用户和聊了三个月的用户,收到的应该是完全不同的回应策略。而多数实现把这件事写成一段"你要像老朋友一样…"的提示词,结果是不可测、不可复现、也说不清为什么这句会这么说。
本项目把这部分单独抽成服务端调度引擎:每收到一条消息,走一遍 S0-S8 管线,输出本轮裁决——当前阶段、阶段内轮次、命中档位、策略 ID、里程碑是否结算、是否发生阶段切换、哪些事件被截断。大模型只收到 3 个字段的请求体(策略 ID、策略指令、用户原话),拿不到轮次、亲密度、里程碑状态这些服务端内部指标。
核心亮点
- 四阶段状态机 + Mermaid 图:破冰期(1-30 轮)→ 熟悉期(1-40)→ 信任期(1-50)→ 深度陪伴期(终态)。破冰期第 1 轮固定走 ENTRY,2-19 轮随机闲聊,第 20 轮才打开里程碑窗口,第 30 轮轮末强制切换——破冰期不存在"第 31 轮",这类边界全部写进 SRD 与测试用例。
- 里程碑锁与顺延:4 个里程碑(首次共鸣 / 仪式 / 脆弱暴露 / 无条件接纳)各自带锁;当一轮同时命中强信号又被策略截断时,锁保持
UNLOCKED、事件顺延到后面窗口,不会出现"该给的没给、不该给的抢着给"。 - 规则版信号检测器:识别负面情绪词(难过 / 压力好大 / 失眠 / 焦虑 / 崩溃)、讲故事信号(我小时候… / 我妈… / 我跟你说个事)、危机高危语句,以及否定守卫——"我不难过,真的没事"不会被误判成正面。检测器是接口,换成真实模型只需实现同一个
detect()。 - 大模型请求体零状态泄露:只发 3 个字段。这条设计让"换个模型试试"变成改配置,而不是把内部状态抄送给第三方。
- 纯标准库 + 191 条测试:配置校验、序列化都手写(约 200 行),换来的是零安装、零版本冲突,任何机器 clone 下来
python -m pytest tests -q就能跑完。含 120 条测试用例清单与 SRD 技术规格文档。
效果预览
python demo.py 的真实输出——每轮裁决、策略 ID、里程碑窗口、发给大模型的 3 字段请求体都打印出来:
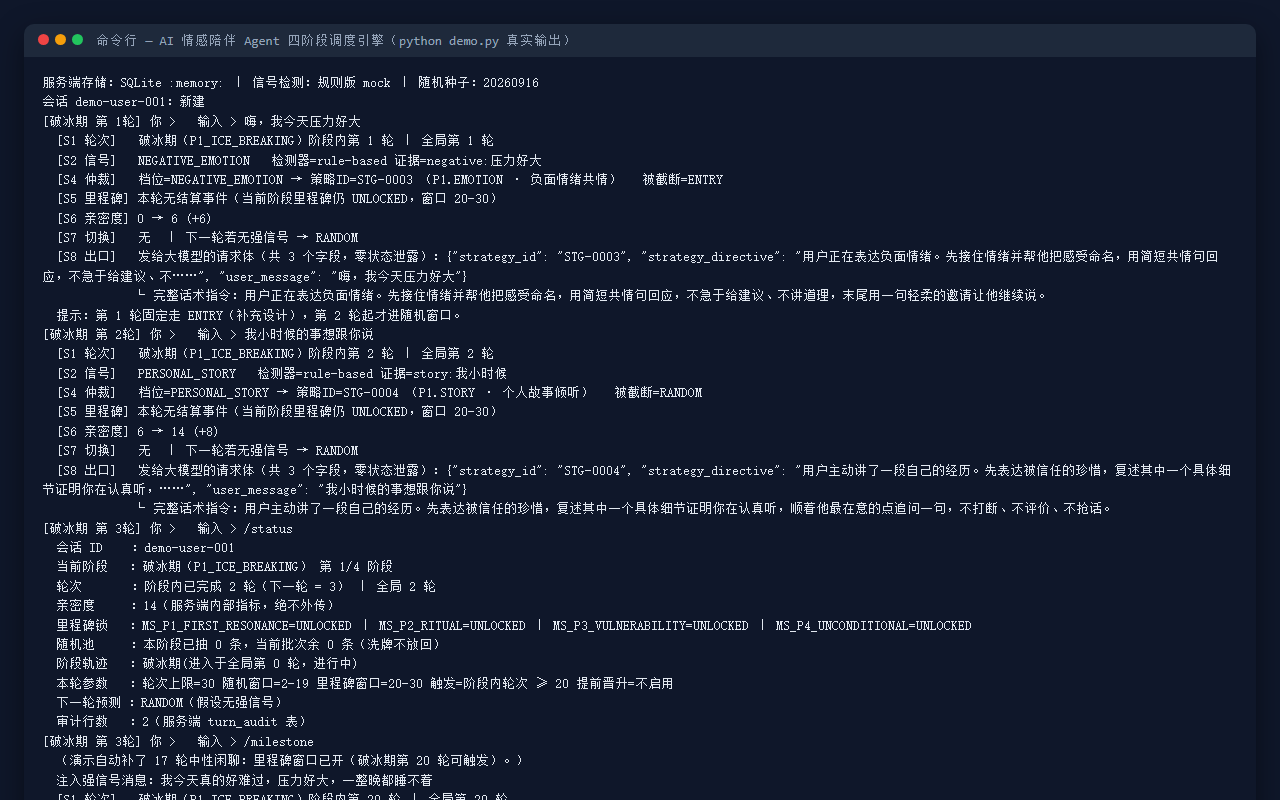
图片为 demo.py 实际运行输出(SQLite 内存库 + 固定随机种子 20260916),同样的输入必然得到同样的结果。
你将学到
- 怎么把"对话策略"从提示词里拆出来,做成有状态、可断言的服务端组件
- 阶段机 + 里程碑锁 + 事件截断顺延的设计方式,以及为什么它比"一段长 prompt"更好测
- 用接口隔离信号检测器与 LLM Provider,让规则版和模型版可互换
- 固定随机种子 + 内存 SQLite 的测试写法:怎么测一个带随机的调度器
- 纯标准库实现配置校验与序列化的取舍(少 200 行依赖,多 200 行自己的代码)
适合谁
要做情感陪伴、导购、客服、教练类多轮 Agent,卡在"策略怎么定、状态放哪、怎么测"的人。难度 ★★★☆:代码量不大,但状态机边界与截断顺延的设计值得逐行读;项目原理.md 里有完整的设计取舍与局限说明。
交付内容:完整可运行源码、README.md(逐步运行方法与实现说明)、requirements.txt。
许可:个人使用,可用于自己的学习、课程实验与研究报告,请勿转售或公开传播。