量化回测勘误 · 完整代码包
这个包是什么
「启迪宽客」两个量化博文系列的全部生成脚本与实测产物,0 元,无需登录、无需下单,点下载直接拿到 zip。
写这两个系列时最大的抱怨对象是我自己:文章里贴的都是片段,读者看完知道"哪里会错",却拿不到"怎么验"。这个包补上这一步——文章里出现的每一个数字,都能在这里找到产生它的那一行代码和那一份 JSON。
- 《币安 15m 回测勘误》9 篇 →
binance-15m/(8 个脚本 + 公共回测器) - 《Python 本地量化》8 篇 →
python-quant/(4 个脚本) - 两边实测产物 →
metrics/(11 份 JSON)
里面有什么
README.md               怎么装依赖、放数据、跑脚本,以及两个系列的共同约定
binance-15m/
  btx.py                公共回测器:成交时点 / 单边扣费 / 比例止盈止损 三个开关
  run_b1.py             数据体检、索引对齐验证、极端单根统计
  run_b2.py             慢线周期扫描(EMA_100 实为 span=130)、成交时点、手续费
  run_b3.py             布林带 ddof 口径、RSI 简单均值 vs Wilder
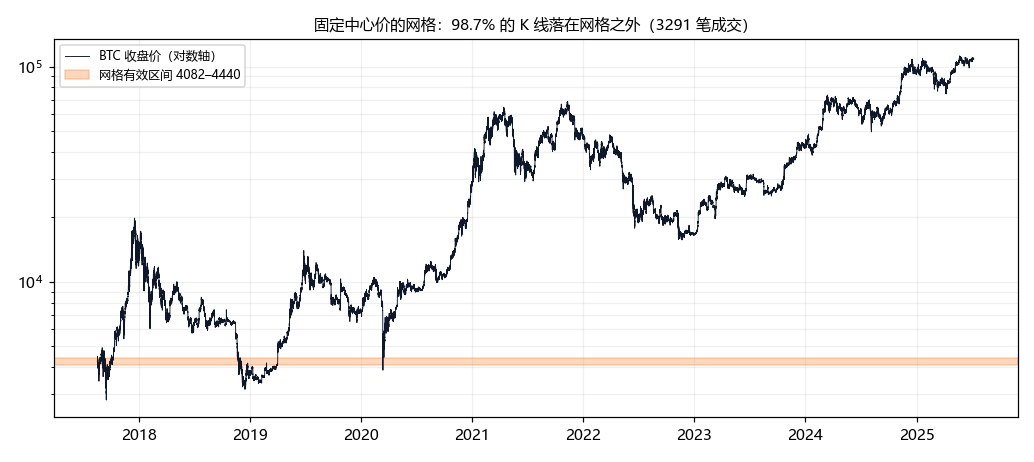
  run_b4.py             固定中心价网格的失效区间;"买入条件其实是动量"的检验
  run_b5.py             三种止盈止损写法(含崩溃复现)与夏普/胜率口径
  run_b6.py             末根未收盘 K 线、drop_duplicates 误删、缺口影响
  run_b7.py             把 notebook 原样重跑,与其保存的输出逐位对账
  run_b8.py             手续费塌陷曲线与盈亏平衡费率(二分法)
python-quant/
  run1.py               A 股日线数据体检与"不复权"判据
  run2.py               双均线向量化、参数网格与样本内外、参数分布
  run3.py               动量、均值回归、框架等价、quantstats 口径复现
  run4.py               RSI 播种差异、事件驱动对账、跳空与覆盖度
metrics/                上述脚本的实测产物,文章数字一律取自这里
核心亮点
- 脚本自己就是证据:
metrics/里的产物是用本包脚本跑出来的,不是另存的旧结果。发布前做过逐字段对账,2194 个叶子值与文章引用值一致(唯一差异是我后加的一个说明字段)。 - 对账做到了原作者头上:
run_b7.py把工程里那份 notebook 的 cell 原样拼接重跑,与它自己保存的输出比对,7 项指标(276050行 /309.96 USDT/209.96%/Sharpe -5.07/Win Rate 59.08%/ 止盈 118 / 止损 442)与 9 行年报逐位复现。 - 一次只改一个开关:
btx.run_loop()把成交时点、买入侧是否扣费、止盈是否查仓位做成参数。所以"网格改成复利反而更差"这类反直觉结果才可能被单独看见,而不是被一个混合数字盖住。 - 复刻优先于正确:公共回测器忠实保留了原代码"买入不扣手续费""期末按盯市值不强制平仓"两个行为,绝对值才能和原作者输出对齐,差异全部归因到你显式打开的那个开关。
- 不藏自己的错:
run_b1.py里有一段专门用来验证我"年报错位一根"假设的代码,实测证明没有错位,第 09 篇按实测收回了这个说法。
效果预览
跑完你会拿到与文章表格逐项对得上的 JSON,例如:
| 数字 | 出处 | 值 |
|---|---|---|
EMA_100 用 span=130 与 100 的收益差 |
第 02 篇 | BTC −2248.93pp,DOGE +1207.71pp(方向相反) |
| 两边都扣 0.1% 后的收益 | 第 04 篇 | BTC +314.45%(原文口径 +3918.52%) |
| 盈亏平衡单边费率 | 第 04 篇 | BTC 0.1500%,DOGE 0.1084% |
| 网格落在区间外的 K 线比例 | 第 07 篇 | 98.7%,2020-03-16 后 5.31 年零成交 |
| 代码自己算的夏普 vs 正确年化 | 第 09 篇 | −3.7305 vs +1.187(符号相反) |
你将学到
- 怎么把"我觉得这里有问题"变成一个可运行的对照实验,并且允许自己被数据否证;
- 成交时点、手续费记法、指标平滑方式这三类"不像策略逻辑"的细节,各自能值多少收益;
- 为什么参数面要整片扫、结论要跨资产看方向——单点比较几乎必然在挑噪声;
- 一份回测报表里,夏普、胜率、逐年收益各自的口径该怎么定义才算说得清。
需要你自己具备的条件(重要)
- 行情数据不在这个包里,要自己取:币安 15m K 线(
datetime,open,high,low,close,volume)或 A 股日线 CSV。README 里写了取法与必须注意的口径(币安那个datetime是 openTime、UTC 无时区)。 - 环境:Python ≥ 3.10,
pandas/numpy/matplotlib;画中文图表需要中文字体,Linux 上把脚本里的Microsoft YaHei换成你自己的字体名。 - 会读 pandas 代码。这个包的脚本按"能读懂、能改"来写,不是一个可复用的回测框架。
适合谁
- 自己写过回测、但对"跑出来的收益能不能信"没有判断手段的人;
- 想看看一个策略从取数到报表,哪些环节各自会吃掉多少收益的人;
- 教课时想给学员一份"错法标本"的人——这里面每个 bug 都真实存在于同一份工程里。
许可:自定义。供学习与研究自由使用、修改、转发,不构成投资建议。 关于免费:这个包 0 元、直接下载,不需要下单也不需要登录。它不参与任何销售,也不承诺能赚钱——恰恰相反,包里的脚本量出来的结论是:这些策略在扣掉真实手续费后大多不成立。