这个项目解决什么问题
心脏病风险预测是二分类问题的经典题材,但多数教程止步于"跑四个模型、打印一个 accuracy"。本项目把重点放在医学场景特有的三个问题上:数据里的缺失与异常怎么处理、阈值怎么和业务目标对齐、结果怎么讲给非技术的人听。全部过程产物(ROC 曲线、混淆矩阵、评分卡、个体报告)自动落盘,可直接作为实验报告素材。
核心亮点
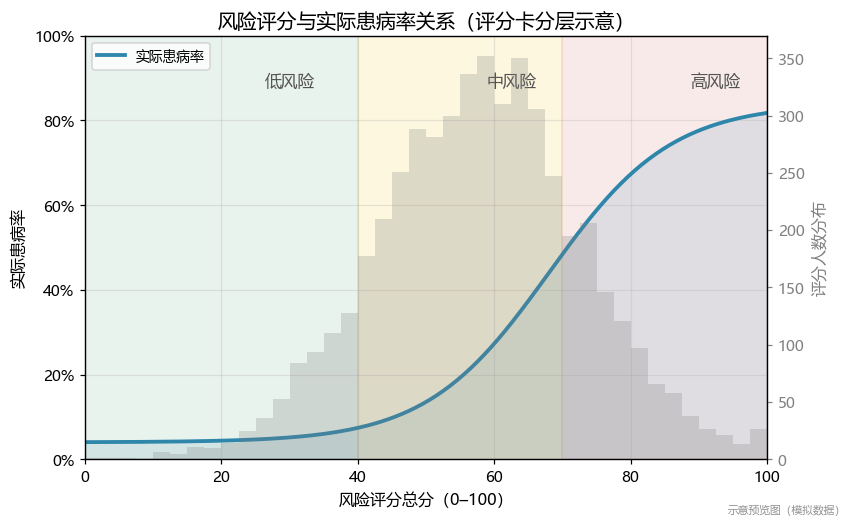
- 医学风险评分卡:把逻辑回归的系数转化为整数评分(思路类似经典的 Framingham 评分),输出各特征的分箱得分表和"总分-患病率"曲线——交付物是一张"人"可以直接用的卡片,而不只是一个黑盒模型。
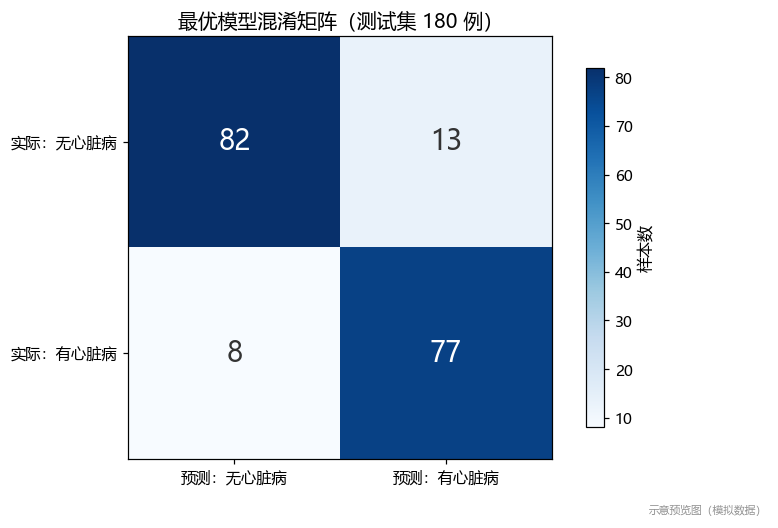
- 双策略阈值优化:同时用 Youden 指数和 F2 分数两条路线寻找最优分类阈值。医学场景宁可多查、不能漏诊,项目输出阈值权衡曲线与两种策略下的漏诊对比,把"阈值怎么选"讲成一堂业务课。
- 个体化病例报告:对单个患者自动生成 HTML 风险报告,包含患病概率、风险分层和特征贡献图——课程汇报时现场输入一个病例,效果直观。
- SHAP 可解释性分析:对模型预测给出每个特征的贡献方向与大小,和评分卡互为印证,构成"模型侧 + 业务侧"双方案解释。
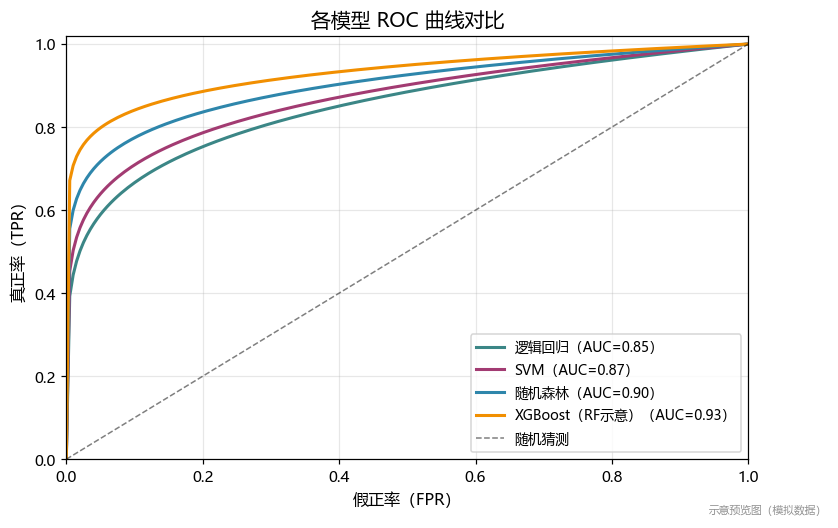
- 四模型同场竞技:逻辑回归 / SVM / 随机森林 / XGBoost 在同一套评估体系下对比,accuracy / precision / recall / F1 / AUC 一张表看清。
- 规范的医学数据清洗:血压、胆固醇中的 0 值按缺失处理、用中位数填充,而不是当真实值喂给模型——细节决定下限。
效果预览
四个模型的 ROC 曲线同图对比,AUC 差异一目了然:
混淆矩阵——结合优化后的阈值,漏诊与误报的权衡清晰可见:
风险评分卡的"总分-患病率"关系曲线,分数越高患病率越高,可以拿给非技术人员直接使用:
预览图基于模拟数据演示实际运行效果,真实数据运行结果以你下载的数据集为准。
你将学到
- 二分类问题的完整流程:清洗 → 编码 → 建模 → 评估 → 解释
- 类别特征编码的常用做法与取舍
- 如何让分类阈值匹配业务目标,而不是默认 0.5 一刀切
- 模型可解释性的两种落地方案(SHAP + 评分卡)
- 面向非技术受众的表达:把概率和系数翻译成"人能用的东西"
适合谁
需要完成分类方向毕业设计、或想在"模型解释 + 业务落地"上拉开差距的学习者。难度 ★★☆,数据量小、跑得快,适合作为第一个完整走通的项目;评分卡与阈值优化部分又能支撑起课程汇报时最有分量的章节。
交付内容:完整可运行源码、README.md(逐步运行方法与实现说明)、requirements.txt。
数据集:第三方数据受原始授权限制不随包分发,按 README.md 里的官方链接下载放入 data/ 即可跑通全流程。
许可:个人使用,可用于自己的学习、课程实验与研究报告,请勿转售或公开传播。