这个项目解决什么问题
联邦学习是"数据孤岛"问题的标准答案:数据不出本地,只上传模型参数。但网上大多数教程止步于"调个 FedAvg API、打印一个精度",对它最著名的短板——Non-IID 数据下客户端漂移导致收敛不稳——要么不讲,要么一笔带过。本项目把 FedProx(FedAvg 的改进版)完整实现一遍,并用对照实验回答"近端项 μ 到底带来了什么",全部过程产物(曲线、分布图、对比表)自动保存,可直接作为实验报告素材。
核心亮点
- 同一算法、双后端实现:PyTorch 自动微分版 + 纯 NumPy 手写前向/反向版,两者接口一致、逐行对应。没有 PyTorch 的机器上
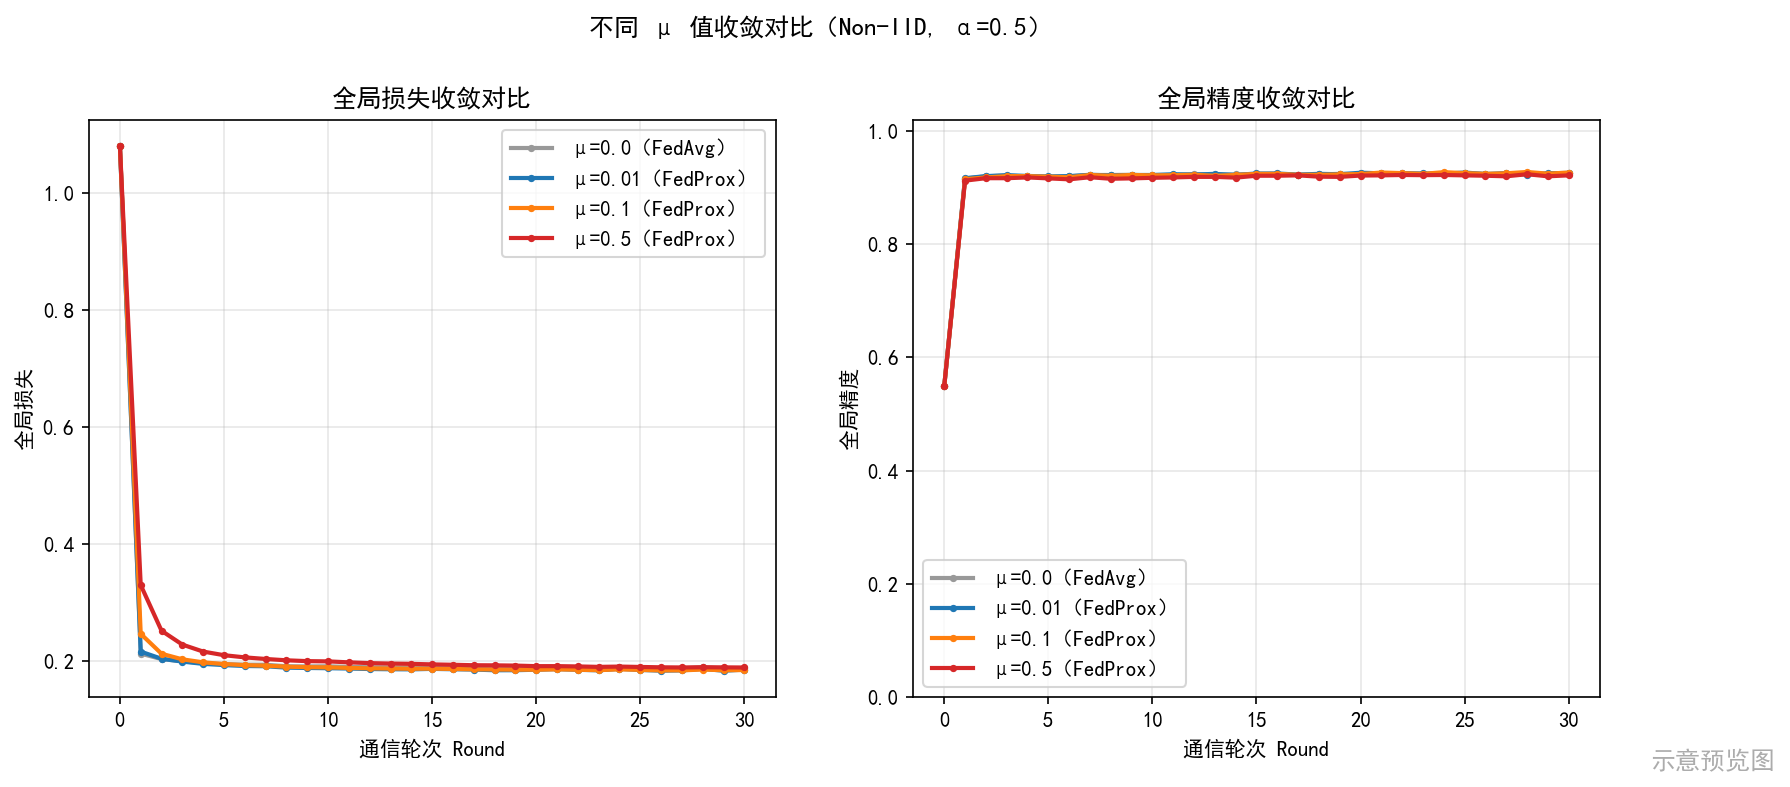
--backend numpy一样完整跑通——不是因为"跑不了才降级",而是把 softmax 回归的梯度、FedProx 近端项的求导自己推了一遍(推导过程就写在源码注释里)。 - FedAvg / FedProx / 不同 μ 的系统性对照:同一份数据、同一种 Non-IID 划分下跑 μ∈{0, 0.01, 0.1, 0.5},μ=0 天然退化为 FedAvg 对照组,收敛对比图 + 汇总表一目了然。
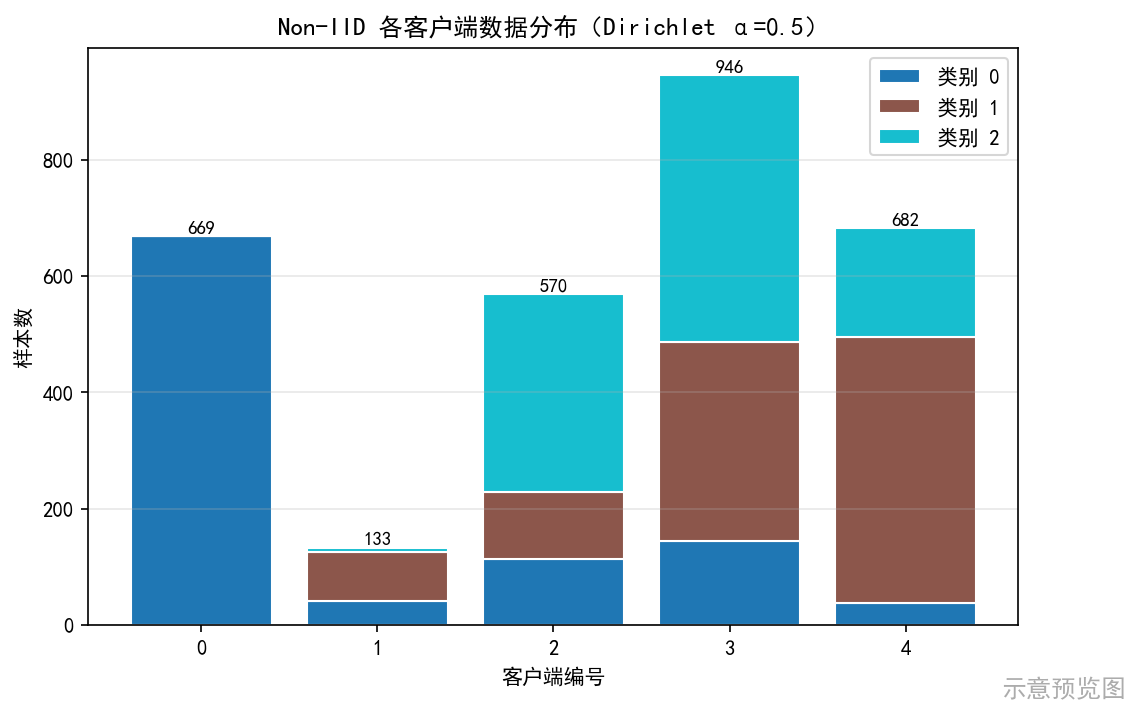
- Dirichlet Non-IID 划分:按联邦学习文献的标准做法把 3000×6 数据切给 5 个客户端,α 可调;各客户端类别分布直方图直观展示"不均衡到什么程度"。
- 客户端掉线模拟:每轮按概率随机让 1 个客户端掉线(不参与训练与聚合),考察部分参与下的鲁棒性——联邦学习落地的真实痛点。
- 一键出全部图表:损失曲线(全局+各客户端)、精度曲线、Non-IID 分布、μ 对比、Non-IID 程度对比,跑完自动落盘
outputs/。
效果预览
Dirichlet(α=0.5)划分下各客户端的类别分布——客户端 0 几乎只有类别 0,Non-IID 程度一眼可见:
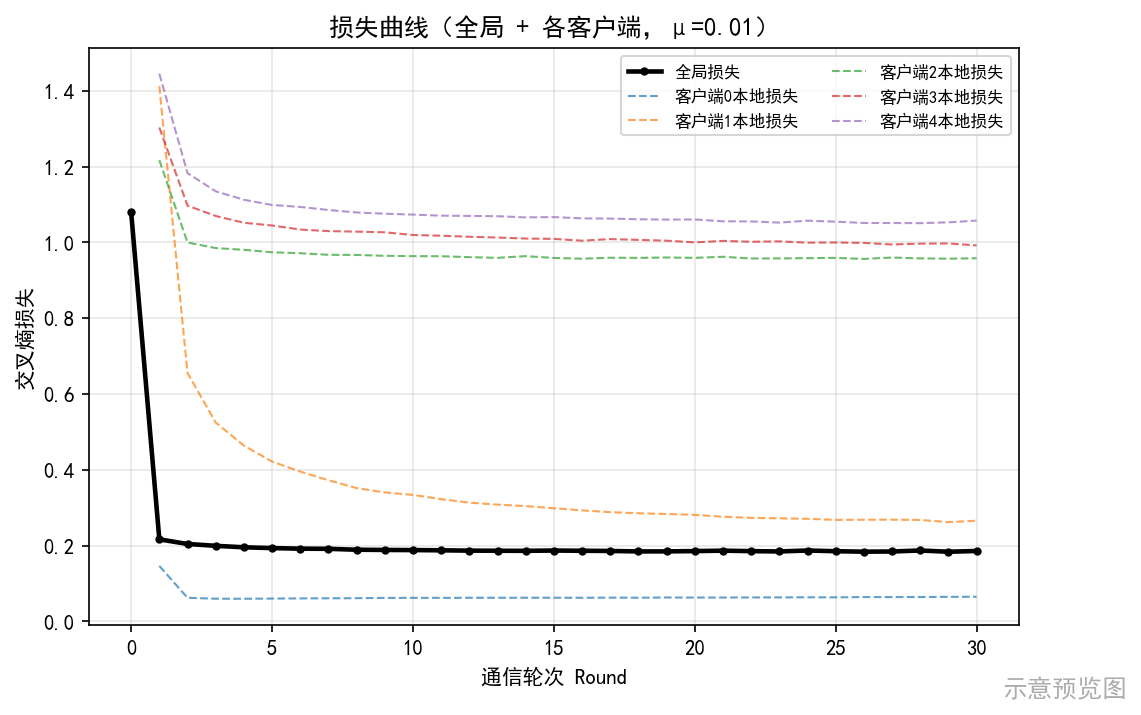
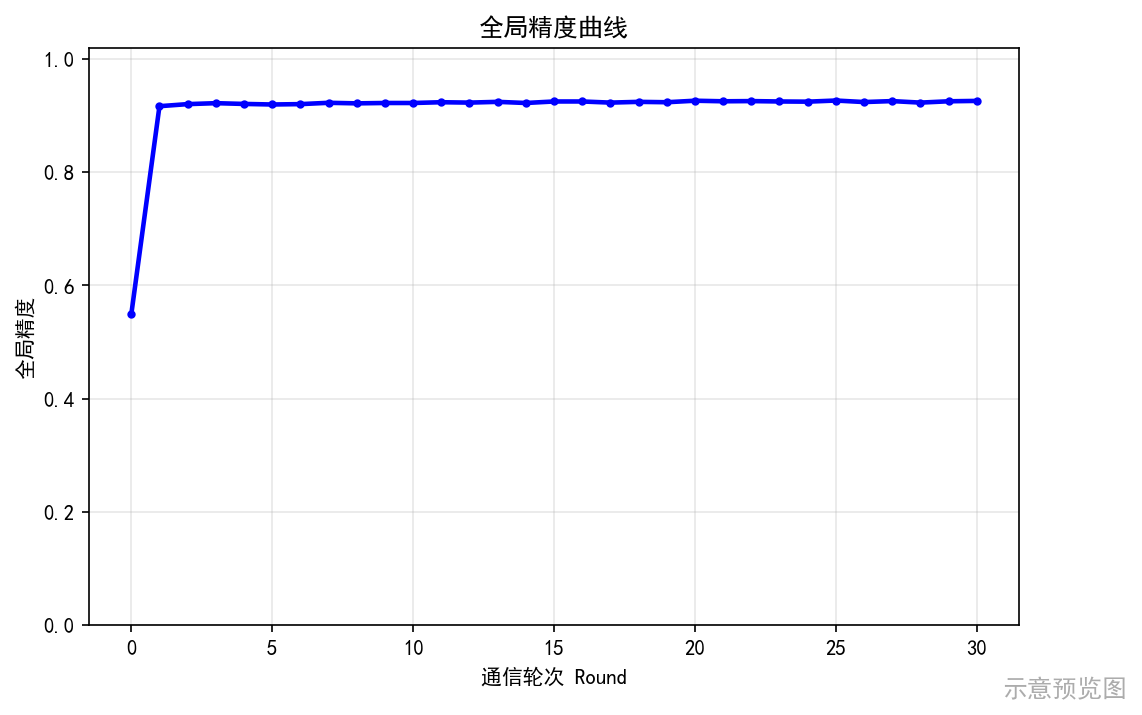
全局损失与精度曲线(μ=0.01),训练过程全程留痕:
四种 μ 值收敛对比——μ=0 即 FedAvg 对照组,μ>0 的 FedProx 曲线更平稳:
预览图基于模拟数据在 NumPy 后端下真实运行生成,参数不同结果会有差异。
你将学到
- 联邦学习的基本范式:本地训练 → 参数上传 → 加权聚合 → 全局评估
- FedProx 近端项的原理、公式与梯度推导,以及它为什么能缓解客户端漂移
- Dirichlet 分布构造 Non-IID 数据划分的标准方法
- 对照实验的设计思路:控制变量、对照组、汇总表
- 同一算法"框架实现 vs 手写实现"的相互验证方法
适合谁
需要完成联邦学习方向毕业设计、或想真正搞懂"FedProx 比 FedAvg 强在哪"的学习者。难度 ★★★,代码中文注释齐全,NumPy 版本无需任何深度学习框架即可跑通。
交付内容:完整可运行源码、README.md(逐步运行方法与实现说明)、requirements.txt。
许可:个人使用,可用于自己的学习、课程实验与研究报告,请勿转售或公开传播。