糖尿病风险预测 · 手写贝叶斯优化器与边界线 SMOTE 预览图

糖尿病风险预测 · 手写贝叶斯优化器与边界线 SMOTE

两个自实现模块:高斯过程代理 + EI/UCB 采集函数、KNN 边界过采样,与 skopt 和标准 SMOTE 对照

源码/项目包 v1.0 # Python# 机器学习# 算法实现

这个项目解决什么问题

糖尿病预测(Kaggle 经典 PIMA 数据集)是二分类的"老面孔",几乎每个人都能搜到一份跑通的教程。本项目刻意在两个最容易"调库糊弄"的环节动真格:超参数优化和类别不平衡处理——自己实现,而不是 import 一个包。做完这两个模块,你对算法的理解会从"会用"变成"会写、会讲"。

核心亮点

  • 自实现贝叶斯优化器:不依赖 skopt,用高斯过程做代理模型,EI / UCB 两种采集函数均为手写,并与 skopt、随机搜索同场竞技、对比收敛速度。课程汇报时说"优化器是我自己写的"和"我用了一下 skopt",完全是两个档次。
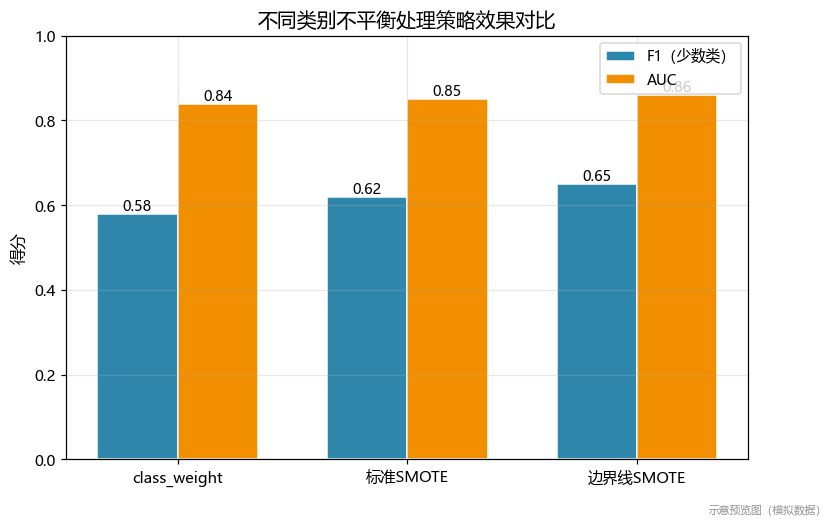
  • 自实现"边界线 SMOTE":纯 numpy 实现,只对靠近决策边界的少数类样本插值合成新样本,并与标准 SMOTE、class_weight 两种策略在同一套评估下对比——每种策略的适用场景你都能说清楚。
  • 风险分层报告:把预测概率划成低 / 中 / 高三层,并验证每层的实际患病率是否校准——分层结果可以直接解释为分诊依据,这是把模型输出"翻译"给业务的典型示范。
  • 模块可独立运行:my_optimizer.py 和 my_smote.py 都能单独跑通做验证,注释里含算法原理与推导,方便逐行阅读、写进实验报告。

效果预览

三种优化器的收敛曲线对比——自实现贝叶斯优化器与 skopt 的表现一目了然:
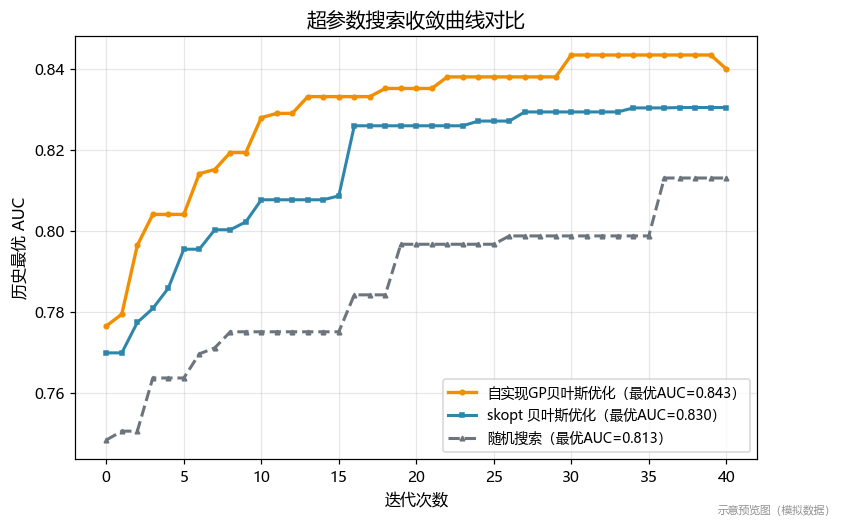
优化器收敛曲线对比

三种不平衡处理策略的对比,"边界线 SMOTE"的取舍清晰可见:

不平衡策略对比

风险分层后各层的实际患病率——分层是否"校准"直接决定它能不能当分诊依据:
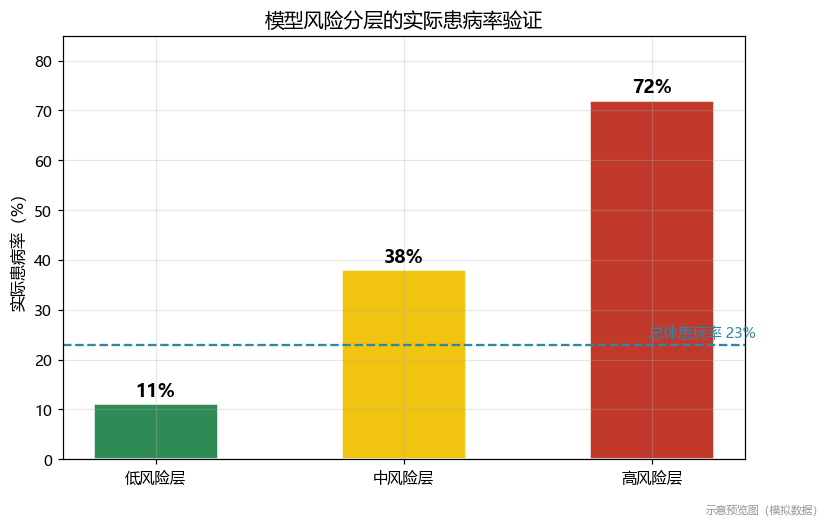
风险分层实际患病率

预览图基于模拟数据演示实际运行效果,真实数据运行结果以你下载的数据集为准。

你将学到

  • 超参数优化的原理与手写实现:高斯过程、采集函数、收敛曲线怎么读
  • 类别不平衡的多种解法:过采样(含边界线变体)、代价敏感,各自适合什么场景
  • 概率校准思维:模型输出的"70%"到底是不是 70% 的患病率
  • 如何把一个"调库项目"升级成"有自己代码贡献的项目"

适合谁

需要完成分类方向毕业设计、且想在课程汇报中展示"算法原理级理解"而非纯调参经验的学习者。难度 ★★★,两个手写模块都有推导注释,跟着读一遍即可消化;如果你想给自己的项目加上"自研算法"的亮点,这里提供了完整的参照。


交付内容:完整可运行源码、README.md(逐步运行方法与实现说明)、requirements.txt。

数据集:第三方数据受原始授权限制不随包分发,按 README.md 里的官方链接下载放入 data/ 即可跑通全流程。

许可:个人使用,可用于自己的学习、课程实验与研究报告,请勿转售或公开传播。

Python 3
pandas
numpy
scikit-learn
XGBoost
自实现贝叶斯优化
自实现边界线 SMOTE

环境与步骤

pip install -r requirements.txt
python main.py            # 全流程 + 图表 + 风险分层报告
python my_optimizer.py    # 单独验证自实现的贝叶斯优化器
python my_smote.py        # 单独验证自实现的边界线 SMOTE

注意事项

  • 数据集不随包提供:先按 README.md 的链接下载放入 data/,再执行下面的命令。

Q:两个自实现模块能单独跑吗?

A:能。python my_optimizer.py 和 python my_smote.py 各自带验证入口与原理注释,不依赖主流程;main.py 再把它们与 skopt、标准 SMOTE、class_weight 放进同一张表对比。

Q:自己都写优化器了,为什么还要装 scikit-optimize?

A:为了当对照组。没有对照,“我手写了一个贝叶斯优化器”只是一句声明。项目比的是收敛曲线,以及“达到 0.99 倍最优所需评估次数”这类可量化指标。

Q:数据要下载吗?

A:要,用的是 PIMA Indians Diabetes(Kaggle 上 uciml 维护的那份),不随包分发,放入 data/ 即可跑通。

Q:边界线 SMOTE 比标准 SMOTE 好在哪?

A:标准 SMOTE 对所有少数类样本一视同仁地插值,会把噪声点也放大。这里先用 KNN 判定哪些样本落在决策边界附近,只对边界的少数类合成新样本并跳过疑似噪声点,纯 numpy 实现,代码里能逐行看到判定过程。

购买评价(0)

暂无评价,购买后第一个来评价吧
相关商品
🍪 隐私提示 我们仅收集提供服务所必需的信息(详见《隐私政策》),不出售、不追踪。
¥69
立即购买