这个项目解决什么问题
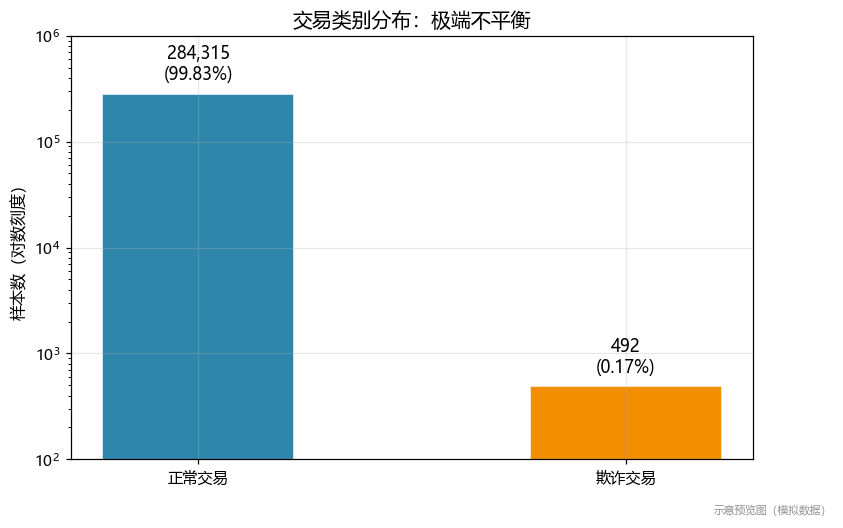
欺诈检测的难点从来不是模型不够花哨,而是两件事:极度不平衡(正负样本 1:578, accuracy 是个骗局)和业务成本不对称(漏掉一笔 5000 元的欺诈,和错拦一位正常客户,代价完全不同)。本项目把这两件事都做成了可量化的流程,并给出一个能模拟线上风控调用的评分接口。
核心亮点
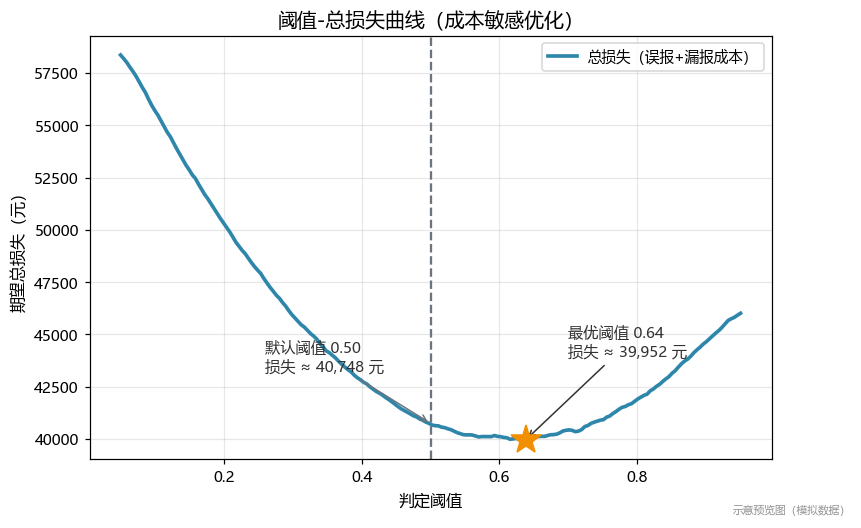
- 成本敏感评估:漏检损失按交易金额计、误报按固定审核成本计,以"总损失最小化"为目标搜索分类阈值,输出阈值-损失曲线。它把"模型指标"翻译成"老板听得懂的钱"——这是本项目区别于普通教程的灵魂模块。
- SMOTE 过采样 + 随机欠采样:两种不平衡处理策略与 class_weight 方案同场对比,谁更适合这个场景,数据说话。
- 无监督异常检测对照:孤立森林与 LOF 在不看标签的情况下能抓住多少欺诈?与监督模型的差距本身就是有价值的分析。
- 时间外推验证:按时间先后切分训练/测试集,模拟"模型上线后面对未来交易"的真实场景,与随机切分对比,暴露数据漂移的影响。
- 规则引擎融合:夜间大额交易等专家规则与模型评分做 OR 融合,"规则 + 模型"的混合风控系统设计。
- 欺诈评分接口:训练完成后保存最优模型,
score_transaction()函数对单笔交易输出欺诈概率——一个可以写进简历的"准生产"封装。
效果预览
99.83% vs 0.17%——先看清楚这个数据集有多"斜":
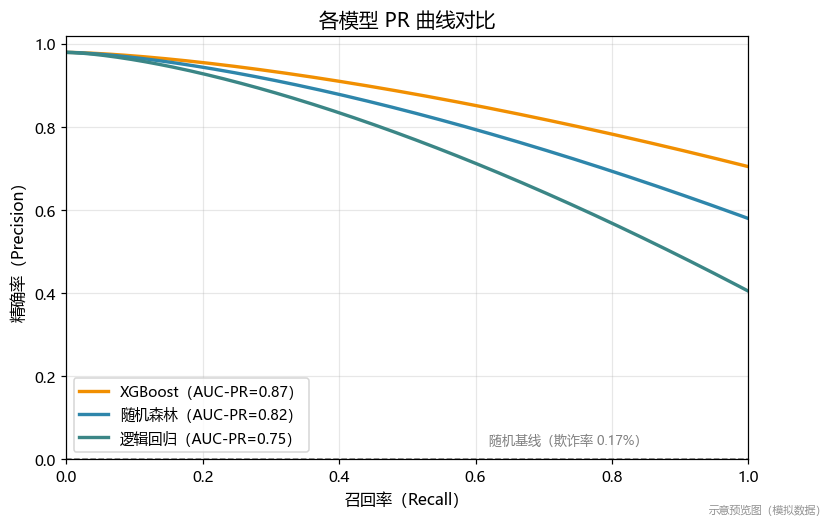
不平衡场景下 PR 曲线比 ROC 更诚实:
阈值-总损失曲线:U 型的最低点就是"最省钱"的决策阈值:
预览图基于模拟数据演示实际运行效果,真实数据运行结果以你下载的数据集为准。
你将学到
- 极度不平衡数据的全套处理思路:采样、类权重、评估指标选择
- 为什么欺诈检测必须看 PR 曲线 / AUC-PR 而不是 accuracy
- 成本敏感决策:如何把混淆矩阵变成一张账单
- 面向部署的模型持久化与单笔交易评分封装
适合谁
想做风控/反欺诈方向、或需要在毕设里体现"业务思维 + 算法能力"的学习者。难度 ★★★,28 万条数据的训练已做采样优化,普通电脑可跑。
模型内部怎么算成本、规则怎么提炼——细节在源码注释里,这里刻意没有展开,留给你自己探索。
交付内容:完整可运行源码、README.md(逐步运行方法与实现说明)、requirements.txt。
数据集:第三方数据受原始授权限制不随包分发,按 README.md 里的官方链接下载放入 data/ 即可跑通全流程。
许可:个人使用,可用于自己的学习、课程实验与研究报告,请勿转售或公开传播。